Ruang Topik: memetakan topik berita Indonesia
- Proyek akhir Text Mining · Teknik Informatika, ITS · 2026
- Proyek tim (3 orang); semua tahap dikerjakan bersama
- Python
- Gensim
- scikit-learn
- BERTopic
- UMAP
- HDBSCAN
- Optuna
- Sentence-Transformers
- Streamlit
Pertanyaannya
Ribuan artikel berita muncul setiap hari. Metode topic modeling mana yang menemukan topik paling jernih dalam berita Indonesia, dan apa yang sebenarnya menggerakkan kualitas neural topic model?
Data
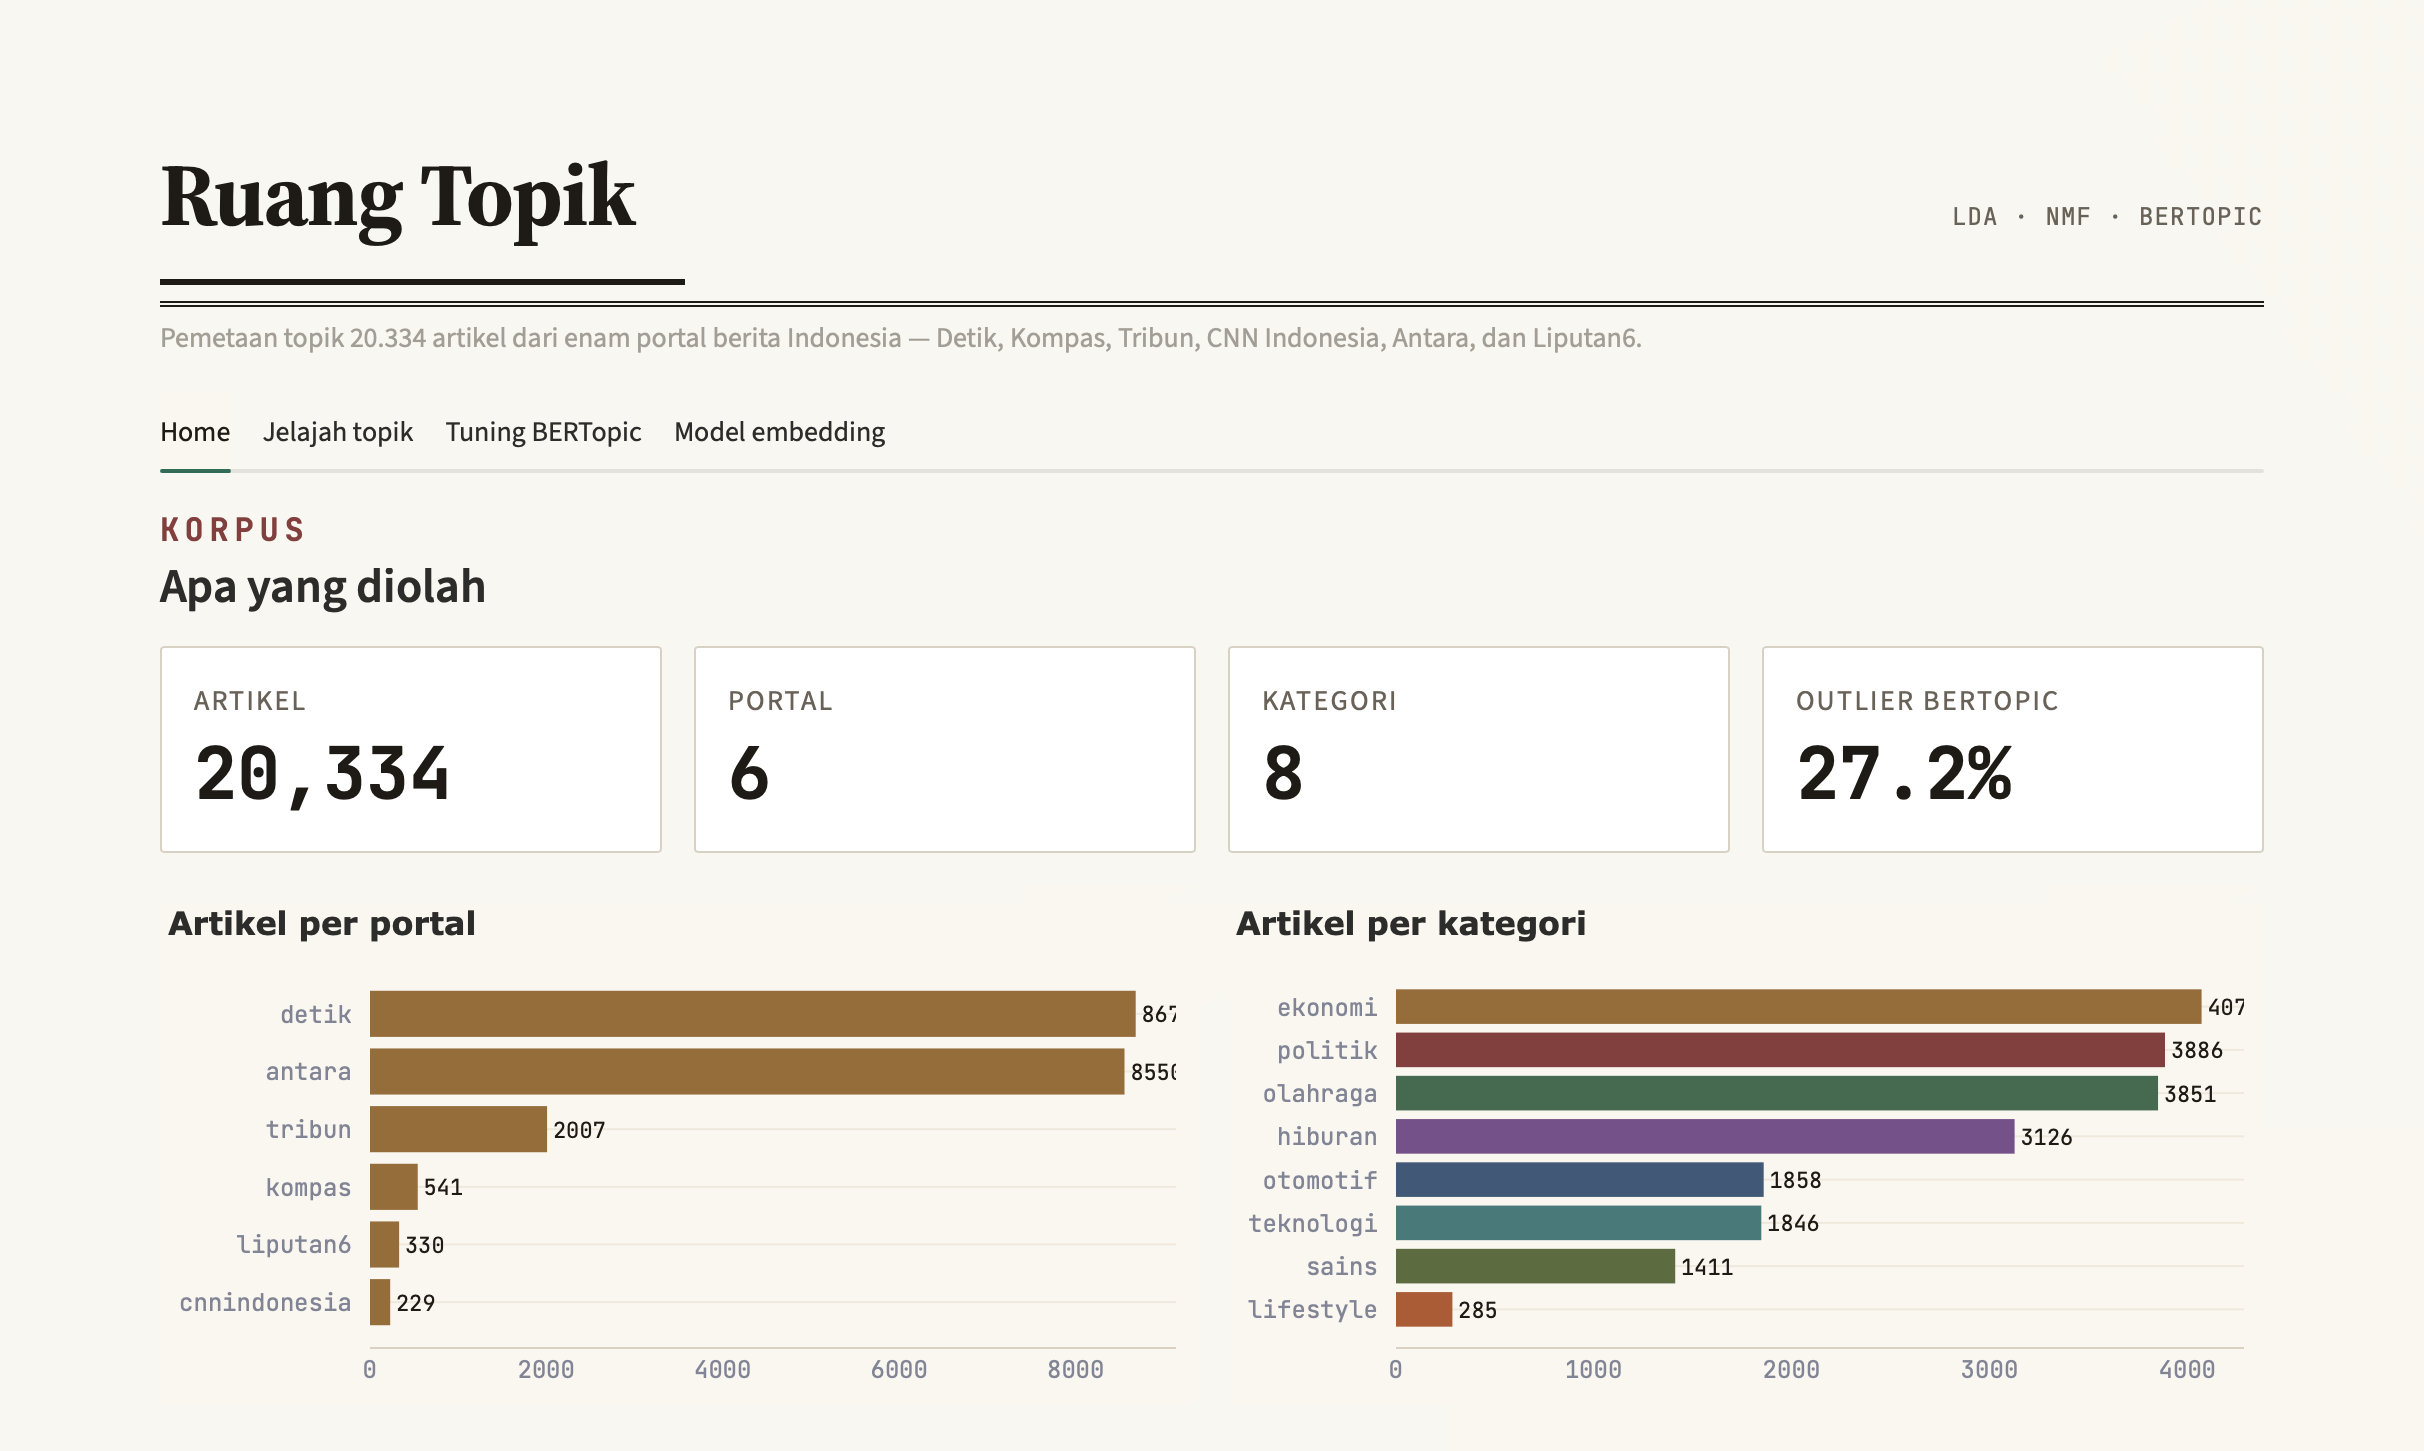
Kami mengambil data dari enam portal nasional (Detik, Antara, Tribunnews, Kompas, Liputan6, CNN Indonesia): judul, tanggal, isi, kategori, portal dan URL. Setelah preprocessing: 20.334 artikel.
Tiga eksperimen
S1 · Metode mana? LDA dan NMF untuk k ∈ {5…30}, BERTopic memilih k sendiri, semuanya dinilai dengan coherence C_v pada kamus dan korpus referensi yang sama.
| Metode | Pendekatan | Topik | C_v |
|---|---|---|---|
| NMF | faktorisasi matriks | 25 | 0,825 |
| BERTopic | embedding kontekstual | 19 (otomatis) | 0,778 |
| LDA | probabilistik | 25 | 0,616 |
NMF menghasilkan topik paling tajam (MotoGP, bulu tangkis, nilai tukar rupiah, makroekonomi). BERTopic lebih granular tapi menyisakan sekitar 27% dokumen sebagai noise. LDA mendapat skor terendah tapi memberi probabilitas topik per dokumen, yang dibutuhkan klasifikasi multi-label.
S2 · Apakah tuning membantu BERTopic? 15 trial Optuna (TPE) atas parameter UMAP dan HDBSCAN.
C_v terbaik 0,799, naik +0,021. min_cluster_size HDBSCAN menjelaskan 81,8% efeknya.
Bahkan trial terburuk (0,758) masih mengalahkan LDA terbaik.
S3 · Apakah model embedding berpengaruh? Lima model sentence embedding. Satu model multilingual umum (paraphrase-multilingual-mpnet-base-v2, C_v 0,803) mengalahkan setiap model khusus bahasa Indonesia (0,728–0,789). Selisih antar embedding (0,075) sekitar 3,5× lebih besar daripada kenaikan dari tuning.
Kesimpulannya
Pada korpus ini, metode klasik menang pada coherence, dan untuk neural topic model representasi jauh lebih berpengaruh daripada hyperparameter clustering. Kosakata berita Indonesia yang campur aduk (kata serapan, nama global) kemungkinan menguntungkan model multilingual.